Ejecutar un modelo de lenguaje en tu propio equipo tiene una barrera clara delante: el modelo, su caché y el entorno de ejecución tienen que caber en la memoria de la tarjeta gráfica. Por debajo de esa línea todo funciona; por encima, el programa se desborda hacia la memoria del sistema y la generación se vuelve lentísima. Este artículo calcula dónde cae esa línea para dieciocho modelos que la gente descarga de verdad, con la misma cuenta que usa nuestra calculadora de VRAM.
En qué se gasta la memoria
- Los pesos: parámetros × bits por peso ÷ 8. Una cuantización de 4 bits de un modelo de 8000 millones de parámetros ocupa unos 4,2 GB.
- La caché KV: 2 × tokens de contexto × capas × cabezas KV × dimensión por cabeza × 2 bytes. Es la parte que sorprende, porque crece con la cantidad de texto en juego.
- La sobrecarga del entorno: medio gigabyte, arriba o abajo, en búferes que reserva el programa.
La fórmula completa y sus límites están en la página de metodología, y la guía de VRAM la recorre con ejemplos resueltos.
La tabla
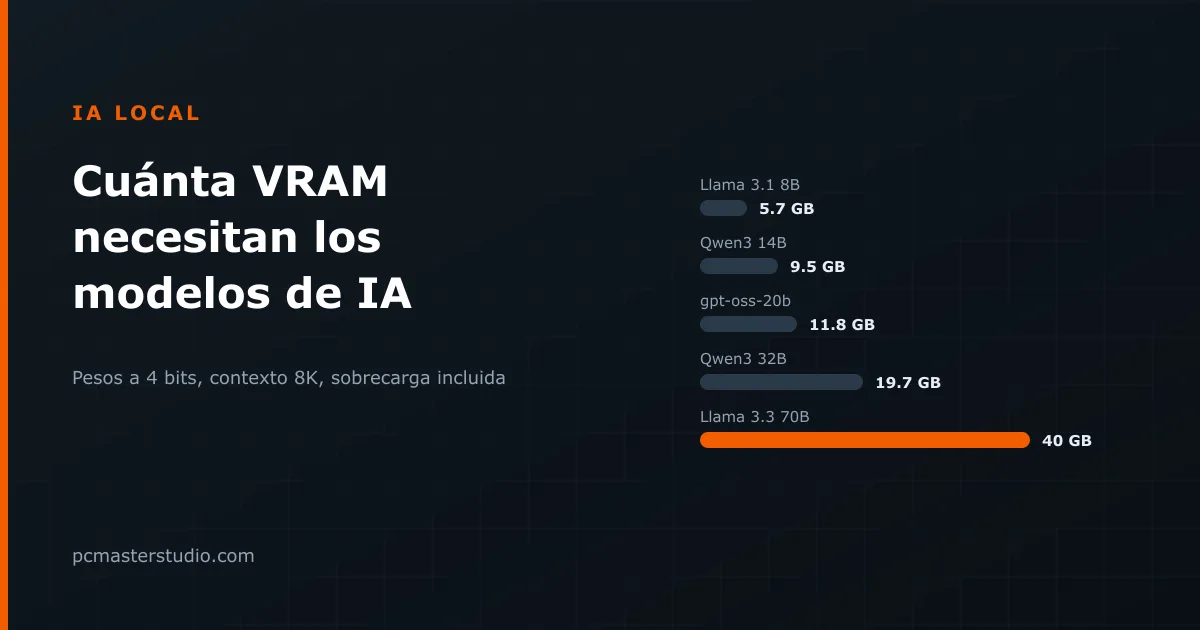
Cifras en gigabytes binarios (GiB), la unidad que muestra tu controlador. Q4_K_M es el formato de 4 bits que casi todo el mundo usa; Q8_0 es el que apenas pierde calidad.
| Modelo | Parámetros | Q4, contexto 8K | Q4, contexto 32K | Q8, contexto 8K |
|---|---|---|---|---|
| Llama 3.2 3B | 3,2 B | 3,1 GB | 5,7 GB | 4,4 GB |
| Qwen3 4B | 4,0 B | 3,7 GB | 7,1 GB | 5,4 GB |
| Gemma 3 4B * | 4,3 B | 3,8 GB | 7,0 GB | 5,6 GB |
| Mistral 7B v0.3 | 7,2 B | 5,3 GB | 8,3 GB | 8,2 GB |
| Qwen 2.5 7B | 7,6 B | 4,9 GB | 6,2 GB | 8,0 GB |
| Llama 3.1 8B | 8,0 B | 5,7 GB | 8,7 GB | 9,0 GB |
| Qwen3 8B | 8,2 B | 5,9 GB | 9,3 GB | 9,3 GB |
| Mistral Nemo 12B | 12,2 B | 8,1 GB | 11,9 GB | 13,1 GB |
| Gemma 3 12B * | 12,2 B | 9,9 GB | 18,9 GB | 14,9 GB |
| Phi-4 14B | 14,0 B | 9,4 GB | 14,1 GB | 15,1 GB |
| Qwen3 14B | 14,8 B | 9,5 GB | 13,3 GB | 15,5 GB |
| gpt-oss-20b * | 20,9 B | 11,8 GB | 12,9 GB | — |
| Qwen3 30B-A3B | 30,5 B | 17,2 GB | 19,5 GB | 29,7 GB |
| Gemma 3 27B * | 27,4 B | 18,7 GB | 30,4 GB | 29,9 GB |
| Qwen3 32B | 32,8 B | 19,7 GB | 25,7 GB | 33,0 GB |
| Mixtral 8x7B | 46,7 B | 26,0 GB | 29,0 GB | 45,0 GB |
| Llama 3.3 70B | 70,6 B | 40,0 GB | 47,5 GB | 68,8 GB |
| gpt-oss-120b * | 116,8 B | 62,3 GB | 63,9 GB | — |
Qué cabe en la tarjeta que tienes
- 8 GB: modelos de hasta 8000 millones de parámetros a 4 bits con contexto corto: Llama 3.1 8B (5,7 GB), Qwen3 8B (5,9 GB), Mistral 7B (5,3 GB). Si subes el contexto a 32K, la mayoría deja de caber con holgura.
- 12 GB: la gama de 12B a 14B a 4 bits: Mistral Nemo (8,1 GB), Phi-4 (9,4 GB), Qwen3 14B (9,5 GB). O un modelo de 8B con 32K de contexto, o uno de 7B a 8 bits.
- 16 GB: gpt-oss-20b (11,8 GB), un modelo de 14B con contexto largo (13-14 GB) o uno de 12B a 8 bits.
- 24 GB: la gama de 27B a 32B a 4 bits: Qwen3 30B-A3B (17,2 GB), Gemma 3 27B (18,7 GB), Qwen3 32B (19,7 GB).
- 32 GB: un modelo de 32B con 32K de contexto (25,7 GB) o Mixtral 8x7B (26,0 GB).
- Por encima: Llama 3.3 70B a 4 bits pide unos 40 GB, lo que significa dos tarjetas de 24 GB, una tarjeta profesional o un equipo con un gran bloque de memoria unificada. gpt-oss-120b necesita unos 62 GB.
Tres cosas que enseña la tabla
El contexto no es gratis
Llama 3.1 8B necesita 1,0 GB de caché con 8K tokens y 4,0 GB con 32K. Los pesos no se movieron; la conversación sí. Si un modelo carga sin problemas y luego se ralentiza o se cae tras una sesión larga, casi siempre es por esto.
El diseño de la atención pesa tanto como el tamaño
Qwen 2.5 7B y Llama 3.1 8B ocupan casi lo mismo y, sin embargo, con 32K de contexto uno necesita 6,2 GB y el otro 8,7 GB. La diferencia está en el número de cabezas clave-valor: cuatro frente a ocho. Los modelos diseñados con menos cabezas KV, o con ventana deslizante como Gemma 3 y gpt-oss, salen mucho más baratos en memoria con entradas largas.
Los modelos de mezcla de expertos son rápidos, no pequeños
Qwen3 30B-A3B activa unos 3000 millones de parámetros por token, así que genera rápido, pero los 30 000 millones tienen que estar en memoria. Lo mismo vale para Mixtral 8x7B y para la pareja gpt-oss. Compran velocidad, no espacio.
Dónde pueden fallar estas cifras
Son una estimación para planificar, no una medición de tu instalación. Cada entorno reserva memoria a su manera: llama.cpp, Ollama, LM Studio y vLLM tienen sus propios búferes. Cuantizar la caché KV a 8 bits reduce aproximadamente a la mitad la columna de la caché. Los modelos con visión añaden un codificador de imágenes. Y el sistema operativo, el escritorio y un navegador ya están usando parte de la memoria de la tarjeta antes de que cargue el modelo, así que conviene dejar uno o dos gigabytes libres en lugar de buscar el ajuste exacto.
Para probar tu combinación de modelo, cuantización y contexto, usa la calculadora de VRAM; para saber a qué velocidad generará en una tarjeta concreta, el estimador de velocidad de inferencia parte del ancho de banda de memoria.