
Calculadora de VRAM para LLM.
Selecciona un modelo de lenguaje, cuantización y longitud de contexto para calcular exactamente cuánta VRAM necesita tu GPU.
5.21GB
Desglose
GPU Recomendada
8GB VRAM — Corre en local
Mínimo recomendado: RTX 5060 · RX 9060 XT 8 GB
Estimación basada en Ollama / llama.cpp. Resultados pueden variar según framework.
¿Nuevo en LLMs locales?
Lee nuestra guía completa sobre cómo correr modelos en tu PC con Ollama.
Preguntas frecuentes
¿Cuánta VRAM necesita un modelo de lenguaje?
Aproximadamente el número de parámetros por los bytes de cada parámetro, más el contexto. Un modelo de 7000 millones a 4 bits necesita unos 4 GB, a 8 bits unos 7 GB y en precisión completa de 16 bits unos 14 GB. Uno de 70B a 4 bits ronda los 40 GB, fuera del alcance de cualquier tarjeta de consumo.
¿Qué me cuesta realmente la cuantización?
Guarda cada peso en menos bits, así que el modelo encoge más o menos en proporción. Pasar de 16 a 8 bits es casi gratis en calidad; 4 bits es el punto habitual de equilibrio y la pérdida es pequeña para la mayoría de usos; por debajo de 4 bits la degradación se nota.
¿Puedo poner una segunda gráfica para que quepa un modelo mayor?
Sí: las capas se reparten entre tarjetas y las capacidades suman, así que dos tarjetas de 16 GB pueden alojar un modelo de 30 GB. Cuenta con perder algo por el tráfico entre ellas, y ten en cuenta que la tarjeta más lenta marca el ritmo.
¿Qué pasa si el modelo no cabe?
Lo que no cabe se desborda a la memoria del sistema, y esa parte funciona a una fracción de la velocidad, porque la memoria del procesador es mucho más lenta que la de la tarjeta. Un modelo que cabe casi entero es usable; uno que casi no cabe, no.
¿Un contexto más largo consume más memoria?
Sí, y se olvida constantemente. La caché de atención crece con el número de tokens en juego, y con contextos largos puede ocupar más que los propios pesos del modelo. Dimensiona para el contexto que piensas usar, no para el más pequeño.
Lecturas relacionadas
Artículos que explican los números con los que trabaja esta página, con ejemplos y fuentes.
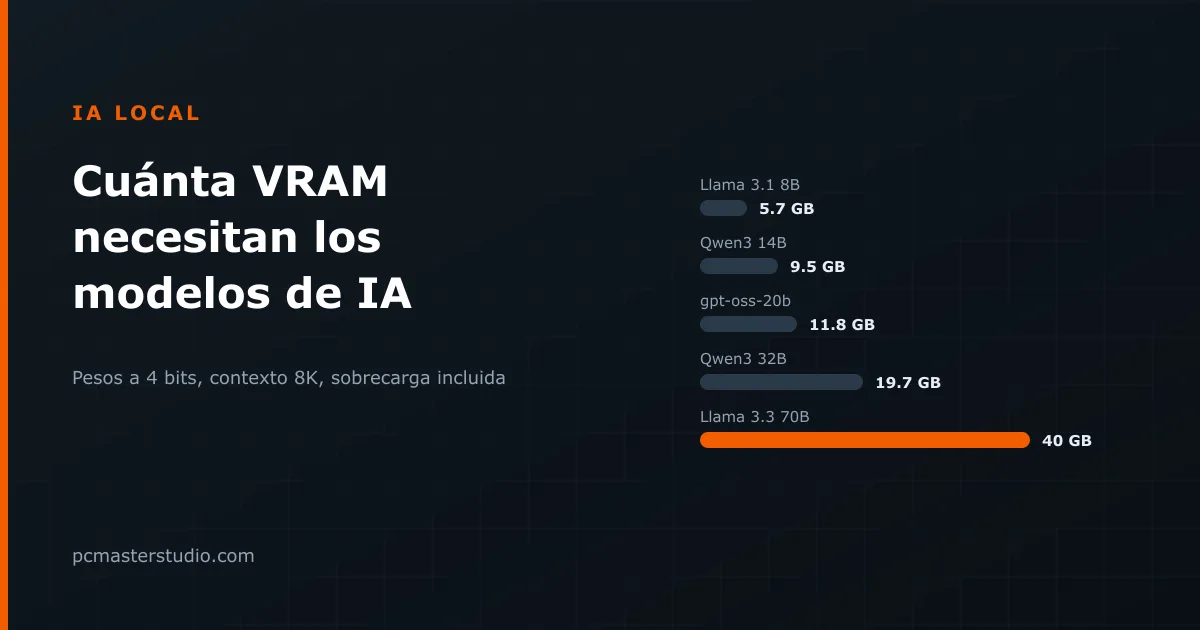 ¿Cuánta VRAM necesitan los modelos de IA locales?Pesos, caché KV y sobrecarga del entorno para dieciocho modelos que la gente descarga de verdad, y qué cabe en una tarjeta de 8, 12, 16, 24 o 32 GB.
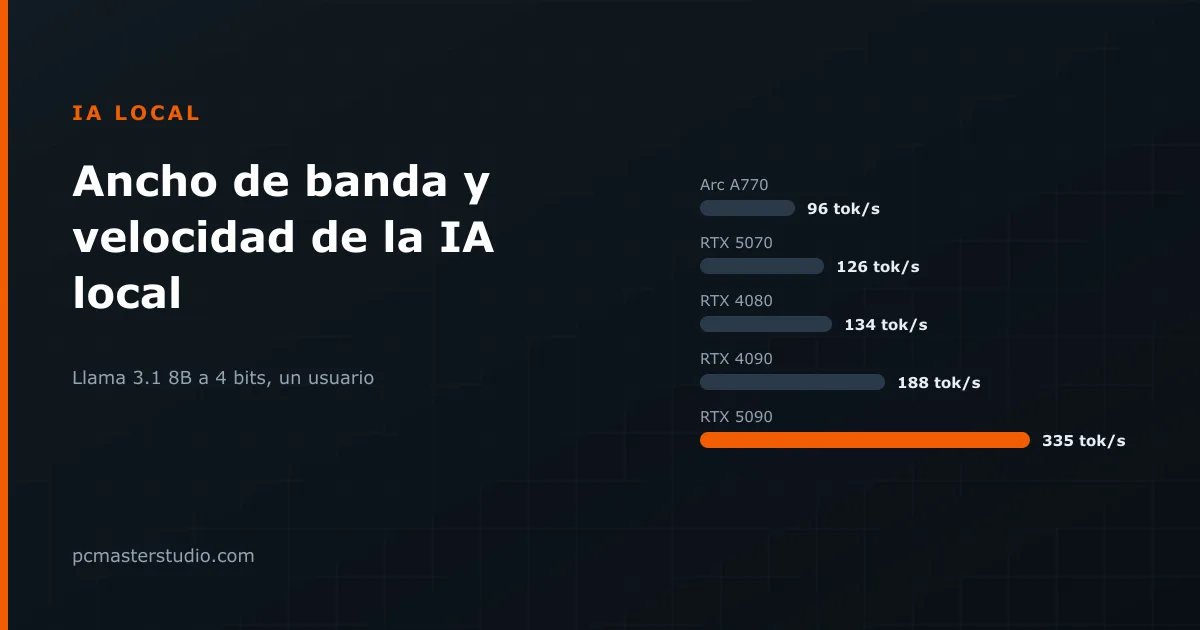 Por qué el ancho de banda decide la velocidad de la IA localUn modelo de lenguaje lee todos los pesos en cada token, así que el límite de velocidad es el ancho de banda de memoria, no el cálculo. Tokens por segundo para nueve tarjetas y tres tamaños de modelo.
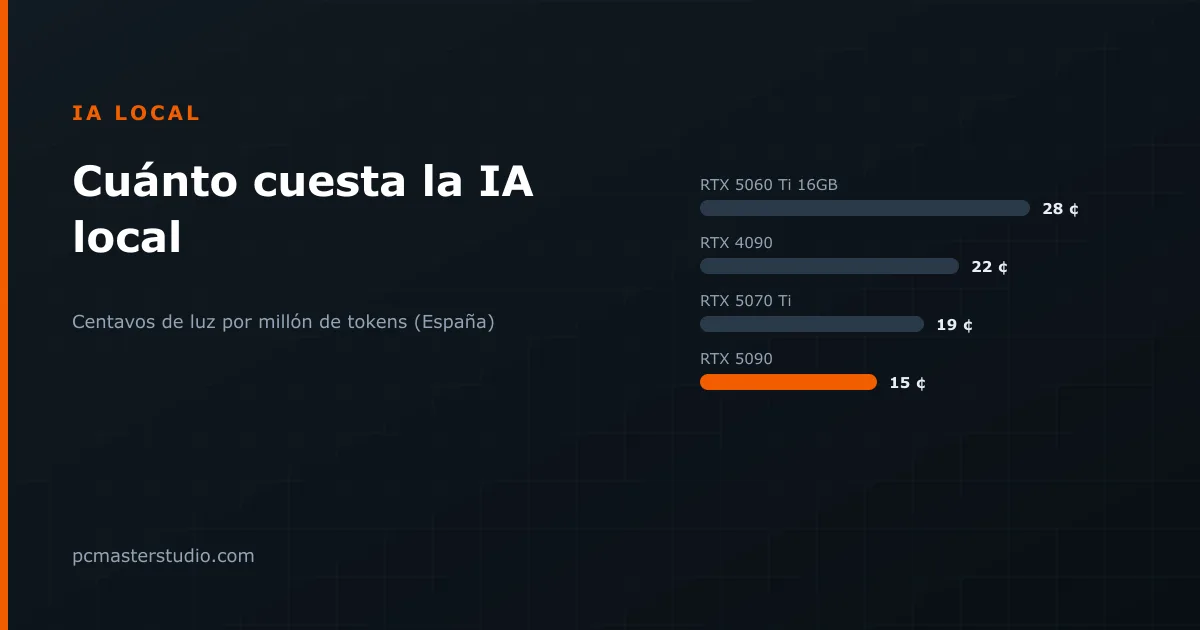 Cuánto cuesta de verdad ejecutar IA en tu propia tarjeta gráficaElectricidad por millón de tokens en cuatro tarjetas gráficas, por qué la más rápida es la más barata por token, lo que añade el hardware y las razones que pesan más que el precio.
Sigue explorando
Otras herramientas y páginas de referencia que continúan donde esta termina.
¿Tienes una web sobre hardware? Pon esta calculadora en ella