Cómo usarla en tres pasos
- Elige el modelo. Los modelos están agrupados por familia. El tamaño en miles de millones de parámetros es lo que determina todo lo demás, así que un «14B» de una familia se comporta de forma parecida a un 14B de otra.
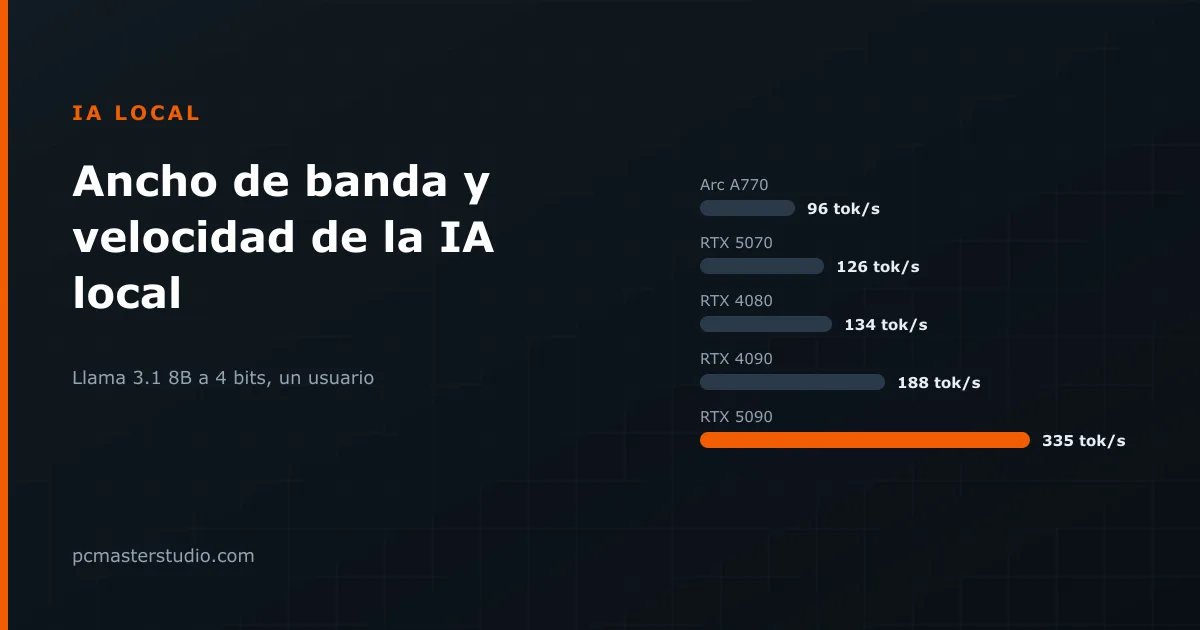
- Elige la tarjeta gráfica. Lo que importa aquí es su ancho de banda de memoria, que aparece bajo cada nombre en GB/s, y su cantidad de memoria. La marca solo importa a través de esas dos cifras.
- Elige la cuantización. Q4_K_M es el punto de partida habitual: una cuarta parte del tamaño del original de 16 bits, con una pérdida de calidad que la mayoría no nota en una conversación. La tabla bajo el resultado muestra el mismo modelo y la misma tarjeta en todos los formatos, para ver qué cuesta subir o bajar.
Qué significan la cifra y las etiquetas
La cifra grande es la velocidad de generación: tokens escritos por segundo una vez que la respuesta ha empezado. Un token equivale más o menos a tres cuartos de palabra en inglés, y algo menos en español. La etiqueta de velocidad sigue tramos fijos: excelente desde 80 tokens por segundo, buena desde 40, moderada desde 15 y lenta por debajo. Por encima de unos 15, el texto sale más rápido de lo que la mayoría puede leer.
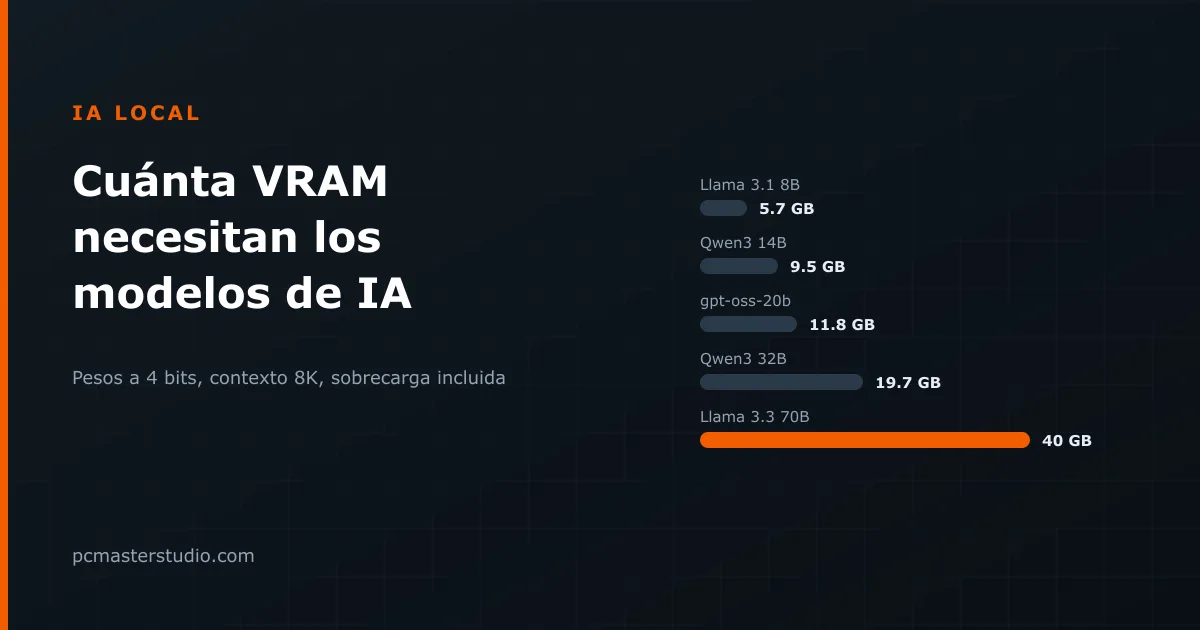
El indicador de memoria compara los pesos del modelo con la memoria de la tarjeta. Hasta el 85 % cabe y deja sitio para el contexto. Entre el 85 % y el 100 % va justo: carga, pero una conversación larga puede no caber. Por encima del 100 % el modelo no cabe, y la herramienta no muestra velocidad en lugar de mostrar una engañosa, porque un modelo que se desborda a la memoria del sistema rinde una pequeña fracción de lo estimado.
El procesamiento del prompt —leer lo que pegas antes de que empiece la respuesta— se muestra a diez veces la velocidad de generación, porque trabaja sobre todo el prompt a la vez y no token a token.
Ejemplos resueltos con el catálogo
- Misma memoria, distinta velocidad. Qwen3 14B en Q4_K_M pesa 7,4 GB. En una RTX 5060 Ti de 16 GB (448 GB/s) da 448 ÷ 7,4 × 0,75 ≈ 45 tokens por segundo. En una RTX 4060 Ti de 16 GB (288 GB/s), unos 29. En las dos cabe el modelo con margen; solo la memoria más rápida hace a la primera un 55 % más veloz.
- La tarjeta más rápida que no puede con él. Qwen 2.5 32B en Q4_K_M necesita 16,3 GB. Una RTX 3090 (24 GB, 936 GB/s) lo mueve a unos 43 tokens por segundo con un tercio de su memoria libre. Una RTX 5080 tiene algo más de ancho de banda (960 GB/s) pero solo 16 GB, así que el mismo modelo la desborda. En modelos locales, la capacidad decide qué puedes ejecutar y el ancho de banda, a qué velocidad.
- Bajar de formato para que quepa. Llama 3.3 70B en Q4_K_M ocupa 35 GB, que desborda incluso los 32 GB de una RTX 5090. En Q3_K_M ocupa 26,3 GB, cabe al 82 % y los 1.792 GB/s de la 5090 dan unos 51 tokens por segundo.
- Un modelo en todos los formatos. Llama 3.1 8B en una RTX 4070 (12 GB, 504 GB/s): FP16 (16 GB) no cabe; Q8_0 va a unos 47 tokens por segundo, Q6_K a 63, Q5_K_M a 75 y Q4_K_M a 94. Cada escalón hacia abajo lee menos datos por token, y por eso la cuantización acelera la generación además de reducir el modelo.
Cuándo fiarse menos
La estimación solo cuenta los pesos del modelo. No incluye la caché KV, que crece con la longitud de la conversación y puede sumar varios gigabytes con contextos largos. Antes de comprar una tarjeta para un modelo concreto, comprueba si cabe en la calculadora de VRAM para LLM, que añade la caché y el consumo propio del programa.
Los modelos de mezcla de expertos se tratan como si se leyeran todos sus pesos en cada token. Qwen3 30B-A3B se cuenta como 15 GB en Q4_K_M y se estima en unos 47 tokens por segundo en una RTX 3090. La cifra de memoria es correcta, porque todos los expertos tienen que estar cargados, pero en cada token solo se lee una pequeña parte de los pesos, así que la generación real en estos modelos suele ser bastante más rápida que la estimación.
También supone una sola tarjeta, una petición cada vez y un programa bien optimizado. Repartir un modelo entre dos tarjetas, atender a varios usuarios a la vez o que el programa caiga en una ruta lenta cambian el resultado. El factor 0,75 y su razonamiento están en la página de metodología.
Usarla para elegir tarjeta
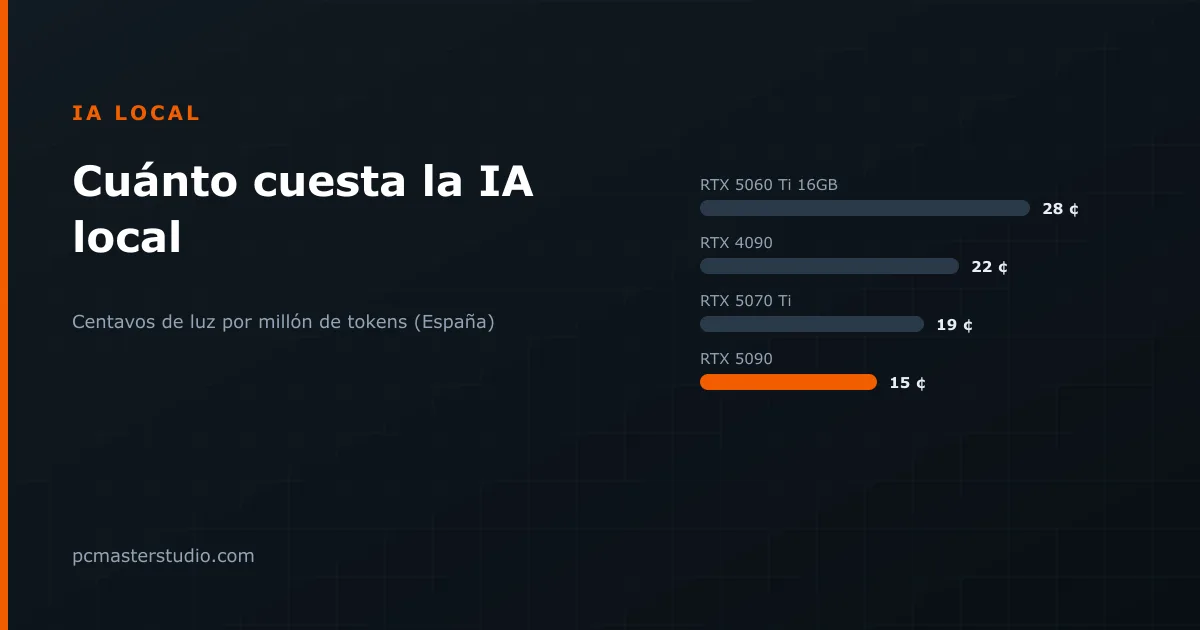
Empieza por el modelo más grande que quieras ejecutar, busca los formatos que caben y solo entonces compara velocidad. La lista de tarjetas más rápidas para el modelo elegido hace exactamente eso, sin aceleradoras de centro de datos. Si la tarjeta que necesitarías cuesta más de lo que vas a usarla, la calculadora de comprar o alquilar GPU muestra cuántas horas de nube paga el mismo dinero, y la calculadora de electricidad, lo que cuesta tenerla funcionando en casa.