
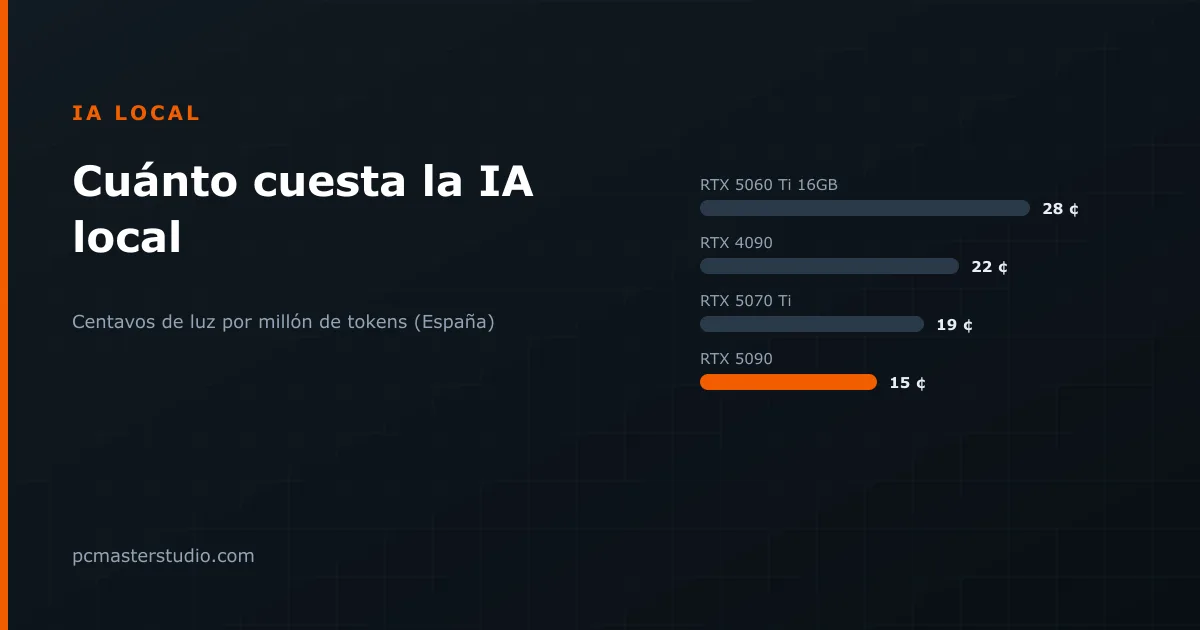
Ejecutar un modelo de lenguaje en tu propia tarjeta gráfica parece gratis una vez pagada la tarjeta. No lo es, y tampoco es tan caro como se teme. El coste se divide en dos partes —la electricidad que gasta cada token y la parte del hardware que cada token consume— y se comportan de forma muy distinta. Este artículo pone precio a las dos para cuatro tarjetas gráficas, y termina con las razones que pesan más que el precio.
La unidad: un millón de tokens
Los servicios de IA en la nube cobran por millón de tokens, así que esa es la unidad que conviene usar también en casa. Un token es un fragmento de palabra; en inglés, un millón de tokens son unas 750 000 palabras, una docena de novelas largas, y en español hacen falta algo más de tokens por palabra. Generar esa cantidad en local lleva unas horas que dependen de lo rápida que sea la tarjeta, y durante esas horas el equipo consume.
La velocidad sale de la misma cuenta que usa nuestro estimador de velocidad de inferencia: el ancho de banda de memoria dividido entre el tamaño del modelo en memoria, por 0,75. El consumo es el nominal de la tarjeta gráfica más 105 W de un procesador corriente y 50 W para el resto del equipo, igual que lo suma nuestra calculadora de fuente de alimentación. Los dos modelos van a 4 bits.
Lo que cuesta la electricidad
| Tarjeta y modelo | Velocidad | Horas por millón de tokens | EE. UU. (0,18 $/kWh) | España (0,25 $/kWh) | Alemania (0,40 $/kWh) |
|---|---|---|---|---|---|
| RTX 5060 Ti 16GB · Llama 3.1 8B | 84 tok/s | 3,3 h | 0,20 $ | 0,28 $ | 0,44 $ |
| RTX 5060 Ti 16GB · Qwen3 14B | 45 tok/s | 6,2 h | 0,37 $ | 0,52 $ | 0,83 $ |
| RTX 5070 Ti · Llama 3.1 8B | 167 tok/s | 1,7 h | 0,14 $ | 0,19 $ | 0,30 $ |
| RTX 5070 Ti · Qwen3 14B | 91 tok/s | 3,1 h | 0,25 $ | 0,35 $ | 0,56 $ |
| RTX 4090 · Llama 3.1 8B | 188 tok/s | 1,5 h | 0,16 $ | 0,22 $ | 0,36 $ |
| RTX 4090 · Qwen3 14B | 102 tok/s | 2,7 h | 0,30 $ | 0,41 $ | 0,66 $ |
| RTX 5090 · Llama 3.1 8B | 335 tok/s | 0,8 h | 0,11 $ | 0,15 $ | 0,24 $ |
| RTX 5090 · Qwen3 14B | 182 tok/s | 1,5 h | 0,20 $ | 0,28 $ | 0,45 $ |
La tarjeta más rápida es la más barata por token
Parece al revés hasta que se ve por qué. La RTX 5090 consume más del doble que la RTX 5060 Ti, pero termina el mismo millón de tokens cuatro veces antes, así que en total gasta menos energía. Por token, la tarjeta que más consume de la tabla es la que menos gasta en electricidad. Generar texto es un trabajo con una cantidad fija de lectura, y hacerlo más deprisa cuesta menos.
El tamaño del modelo duplica la factura
Pasar de un modelo de 8000 millones de parámetros a uno de 14 000 millones duplica más o menos el coste en todas las tarjetas, porque hay aproximadamente el doble de pesos que leer en cada token. Igual que con la velocidad, elegir el modelo mueve la cifra más que elegir la tarjeta.
Lo que cuesta el hardware
La electricidad resulta ser la parte pequeña. La grande es la propia tarjeta, repartida entre todos los tokens que genere en su vida:
coste del hardware por millón de tokens = precio de la tarjeta ÷ millones de tokens que genera en su vida útil
Pongamos una tarjeta que costó 800 $ y se usa durante tres años. Generando un millón de tokens al día —un uso intenso, un asistente funcionando todo el día o un trabajo por lotes cada noche— son unos 1100 millones de tokens, es decir, unos 0,73 $ por millón. Generando 100 000 tokens al día, que para una persona es mucha conversación, son unos 7,30 $ por millón. La parte del hardware baja en proporción directa a lo mucho que la uses.
Ese es todo el argumento económico en una línea: la IA local solo es barata por token para quien genera muchísimo. Para un uso ocasional, el coste es la tarjeta y la electricidad es calderilla. Compara el resultado con el precio por millón de tokens que publica tu proveedor en la nube para un modelo de tamaño parecido antes de decidir, y ten en cuenta que una tarjeta que ya tienes para jugar tiene, para esto, un coste de hardware casi nulo.
Las razones que no son de precio
Para la mayoría de quienes ejecutan modelos en local, el coste no es el motivo. Suelen ser otros tres:
- Privacidad. Nada sale del equipo. Documentos, código y conversaciones se quedan en tu propio disco, y para algunos trabajos es la única opción aceptable.
- Estabilidad. Un modelo descargado no cambia. Un servicio en la nube puede cambiar su modelo, sus funciones o su comportamiento de un día para otro, sin que actualices nada y sin forma de volver a la versión de la semana pasada. El software instalado en local se puede congelar en una versión que funciona; un servicio no.
- Disponibilidad. Sin caídas, sin límites de uso, sin red. El modelo responde en un avión.
La contrapartida es la capacidad. Los modelos que caben en una tarjeta de consumo —hasta unos 30 000 millones de parámetros a 4 bits en 24 GB— son buenos y mejoran, pero no son los modelos más grandes que ejecutan los servicios en la nube. Que eso importe depende por completo de la tarea.
Dónde pueden fallar estas cifras
Las velocidades son estimaciones a partir del ancho de banda, no mediciones, y los entornos reales quedan algo por encima o por debajo. El consumo mientras se genera texto suele estar por debajo del nominal, así que la columna de electricidad es un techo. El tiempo en reposo también cuesta: un equipo encendido todo el día esperando preguntas consume sin hacer nada. Y las tarifas varían mucho dentro de cada país. Para tus propias cifras, busca la velocidad de tu tarjeta y tu modelo en el estimador de velocidad de inferencia, comprueba que el modelo cabe con la calculadora de VRAM, y mete el consumo y tus horas en la calculadora de coste eléctrico.