Dos tarjetas gráficas con la misma cantidad de memoria pueden generar texto a velocidades muy distintas, y la especificación que predice esa diferencia no es la que viene en grande en la caja. Es el ancho de banda de memoria. Este artículo explica por qué, pone cifras reales a nueve tarjetas y señala dónde deja de valer la regla.
Por qué el ancho de banda y no el cálculo
Un modelo de lenguaje escribe un token cada vez, y para producir cada uno tiene que leer todos los pesos que va a usar. Un modelo de 8000 millones de parámetros cuantizado a 4 bits ocupa unos 4 GB de pesos. Generar 100 tokens por segundo significa mover 400 GB por segundo, cada segundo, desde la memoria de la tarjeta hasta sus unidades de cálculo.
Es una cantidad enorme de tráfico y casi nada de aritmética por byte movido: una multiplicación y una suma por cada peso leído. Las unidades de cálculo terminan su parte y esperan. Así que el techo lo marca la velocidad a la que se puede leer la memoria, y la estimación sale de una división:
tokens por segundo ≈ ancho de banda ÷ tamaño del modelo en memoria, por un factor de eficiencia que cubre el tráfico que no son pesos. Nuestro estimador de velocidad de inferencia usa 0,75, y la página de metodología explica de dónde sale esa cifra.
Las cifras
Pesos de 4 bits (Q4_K_M), así que el tamaño en gigabytes es más o menos la mitad del número de parámetros. Un guion significa que los pesos no caben en la memoria de la tarjeta.
| Tarjeta | Ancho de banda | Memoria | Llama 3.1 8B | Qwen3 14B | Qwen3 32B |
|---|---|---|---|---|---|
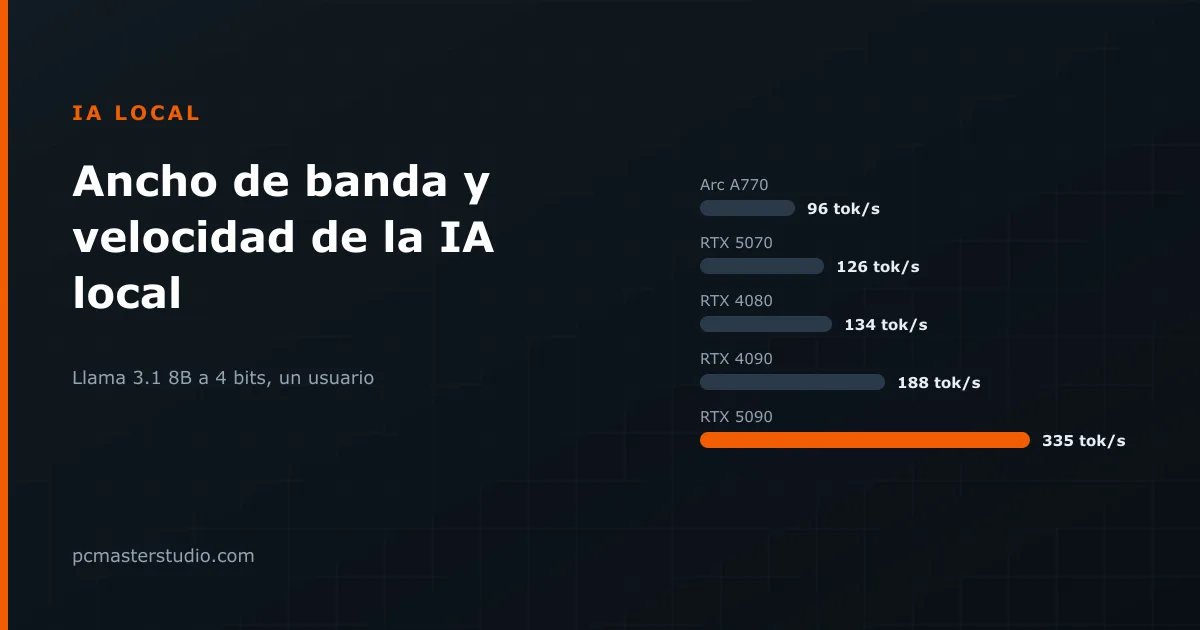
| RTX 5090 | 1792 GB/s | 32 GB | 335 tok/s | 182 tok/s | 82 tok/s |
| RTX 4090 | 1008 GB/s | 24 GB | 188 tok/s | 102 tok/s | 46 tok/s |
| RTX 5080 | 960 GB/s | 16 GB | 179 tok/s | 97 tok/s | — |
| RTX 5070 Ti | 896 GB/s | 16 GB | 167 tok/s | 91 tok/s | — |
| RTX 4080 | 717 GB/s | 16 GB | 134 tok/s | 73 tok/s | — |
| RTX 5070 | 672 GB/s | 12 GB | 126 tok/s | 68 tok/s | — |
| RX 7800 XT | 624 GB/s | 16 GB | 117 tok/s | 63 tok/s | — |
| RTX 3070 Ti | 608 GB/s | 8 GB | 114 tok/s | 62 tok/s * | — |
| Arc A770 | 512 GB/s | 16 GB | 96 tok/s | 52 tok/s | — |
Tres cosas que conviene leer en ella
El tamaño y la velocidad de la memoria son dos puertas distintas
La RX 7800 XT y la RTX 5070 lo ilustran. La Radeon tiene más memoria —16 GB frente a 12—, así que sostiene un modelo que la GeForce no. La GeForce tiene más ancho de banda, así que en un modelo que ambas sostienen genera más rápido. La capacidad decide si un modelo funciona; el ancho de banda decide a qué velocidad. Comprar mirando una y esperando la otra es el error más común aquí.
La RTX 3070 Ti es la versión más cruda de la misma lección. Con 608 GB/s mueve datos más rápido que una Arc A770, pero con 8 GB queda fuera de todo lo que pase de unos 13 000 millones de parámetros. Su velocidad es real y casi inservible.
La diferencia entre generaciones es una diferencia de memoria
La RTX 5090 genera alrededor de 1,8 veces más tokens por segundo que una RTX 4090 con el mismo modelo. Su ancho de banda es unas 1,8 veces mayor. No es casualidad, y es la razón de que las comparativas de rendimiento en juegos sean mala guía para esta tarea concreta: miden una carga limitada por otra cosa.
Los modelos grandes son lentos en cualquier tarjeta
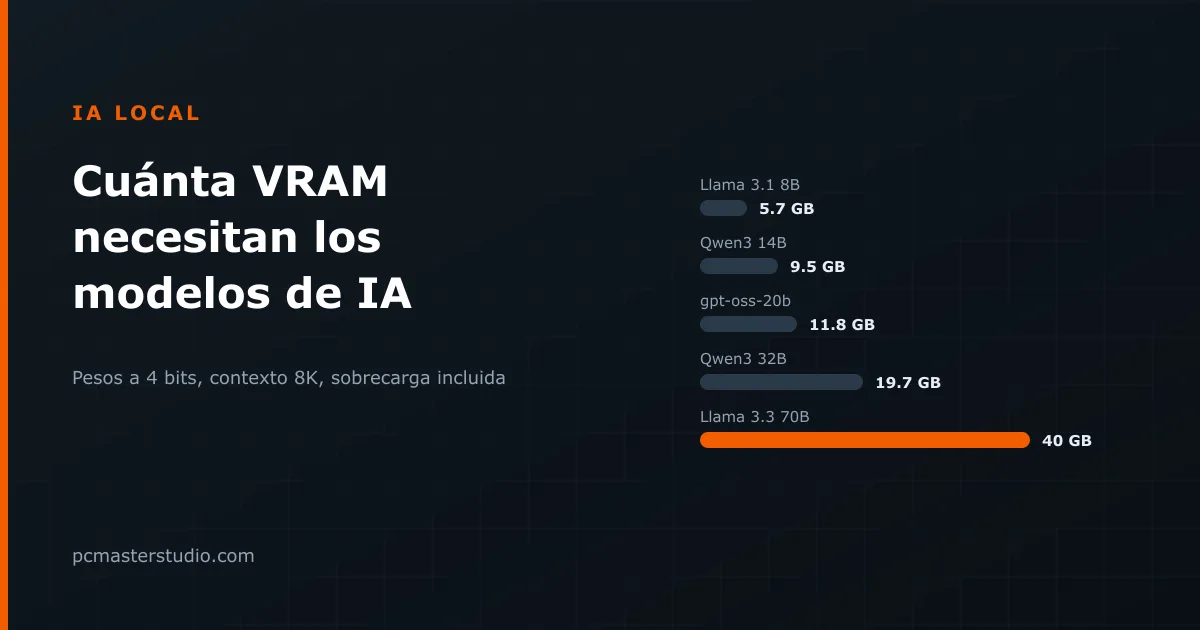
Qwen3 32B necesita unos 16 GB de pesos. Incluso en una RTX 5090, con el mayor ancho de banda de esta lista, eso son 82 tokens por segundo: más rápido de lo que lees, pero una cuarta parte de lo que esa misma tarjeta hace con un modelo de 8B. No hay ninguna tarjeta en la que un modelo de 32B vaya ágil como va uno pequeño. Si lo que importa es que responda rápido y no que responda hondo, elegir el modelo mueve la cifra mucho más que elegir la tarjeta.
El caso que rompe la clasificación
La memoria unificada de Apple es la excepción interesante. Un M3 Ultra ofrece 819 GB/s —entre una RTX 4090 y una RTX 5080— pero se puede configurar con hasta 256 GB compartidos entre el procesador y las unidades gráficas. En un modelo de 70B, que ninguna tarjeta gráfica de consumo sostiene, esa máquina es la que lo ejecuta, a la velocidad que alcanzaría una GeForce de gama media si tuviera la memoria.
El intercambio se ve en la propia lógica de la tabla: Apple gana en capacidad por euro a estos tamaños y pierde en ancho de banda bruto contra una tarjeta tope de gama. Cuál de las dos importa depende por entero de si el modelo que quieres cabe.
Lo que la estimación no cubre
Leer un prompt largo es otra tarea. El prefill procesa todos los tokens de entrada a la vez, lo que carga de aritmética en lugar de memoria, así que va aproximadamente un orden de magnitud más rápido y lo limita el cálculo. Una tarjeta que aquí parece lenta puede digerir un documento largo deprisa.
El procesamiento por lotes también cambia el cuadro: atender varias peticiones a la vez lee los pesos una sola vez para todas, así que los tokens por segundo del conjunto suben muy por encima de estas cifras. Los números de arriba describen a una persona escribiéndole a un modelo, que es lo que hace un ordenador de escritorio.
Y el factor de eficiencia es un único número que sustituye a muchas cosas: tráfico de caché, atención sobre el contexto, calidad de los kernels, si el entorno es llama.cpp o vLLM, y lo caliente que esté la tarjeta. Trata la tabla como una clasificación fiable y como un valor absoluto que no lo es, y comprueba tu combinación en el estimador de velocidad de inferencia. Para saber si un modelo cabe antes de preocuparte por lo rápido que va, la calculadora de VRAM responde a esa primera pregunta.